الدلالة الإحصائية في الاستبيانات: هل الفرق حقيقي؟
كيف تميّز التغيّر الحقيقي من الضجيج: هامش الخطأ، واختبار z لنسبتين بحسابات مفصلة، والشرائح الصغيرة، والمقارنات المتعددة، والأهمية العملية.
في هذه الصفحة
- ماذا تعني الدلالة الإحصائية في نتائج الاستبيان
- هامش الخطأ لنسبة واحدة
- كيف تقارن بين نسبتين: اختبار z لنسبتين
- لماذا تضلّل الشرائح الصغيرة
- المقارنات المتعددة: اختبر 20 فرقًا وسيبدو أحدها حقيقيًا على الأرجح
- الأهمية العملية مقابل الدلالة الإحصائية
- متى لا يستطيع الاستبيان الإجابة عن السؤال
- الأخطاء الشائعة
- كيف تفعل ذلك في Claform
- الأسئلة الشائعة
يكون الفرق بين نتيجتين في استبيان ذا دلالة إحصائية حين يكون أكبر مما يمكن أن تنتجه عشوائية المعاينة وحدها على نحو معقول. ولمقارنة نسبتين مئويتين، استخدم اختبار z لنسبتين: اقسم الفرق على خطئه المعياري، وقارن الناتج بالقيمة 1.96، وهي العتبة عند مستوى ثقة 95 بالمئة. فارتفاع من 58 إلى 64 بالمئة بنحو 400 رد في كل موجة يعطي z = 1.79، وهي قيمة لا تبلغ العتبة.
يتناول هذا الدليل هامش الخطأ لنسبة واحدة، واختبار المقارنة بين نسبتين، وفروق NPS، والشرائح الصغيرة، وإجراء مقارنات كثيرة، والأسئلة التي لا يحسمها أي اختبار.
ماذا تعني الدلالة الإحصائية في نتائج الاستبيان
تجيب الدلالة الإحصائية عن سؤال محدد: لو لم يكن هناك فرق حقيقي في المجتمع، فكم مرة سيظهر فرق بهذا الحجم لمجرد من صادف أن أجاب؟ هذا الاحتمال هو القيمة الاحتمالية (p). وحين تقل عن 0.05 توصف النتيجة بأنها دالة إحصائيًا عند مستوى ثقة 95 بالمئة.
لكنها لا تخبرك هل الفرق كبير بما يكفي ليُحدث أثرًا، ولا هل وصل الاستبيان إلى الأشخاص المناسبين، ولا لماذا يوجد الفرق. هذه الأسئلة تأتي لاحقًا في هذه الصفحة، وهي تحسم القرار أكثر مما تحسمه القيمة الاحتمالية.
هامش الخطأ لنسبة واحدة
هامش الخطأ هو المدى المحيط بنسبة مئوية واحدة الذي يمكن أن تفسّره عشوائية المعاينة. وبالنسبة إلى نسبة مأخوذة من عينة عشوائية بسيطة:
MOE = z × √( p × (1 − p) / n )

z = 1.96 لمستوى ثقة 95% (و1.645 لـ 90%، و2.576 لـ 99%)
p = النسبة التي تعلنها، بصيغة عشرية
n = عدد الردود المكتملة على هذا السؤال
مثال محسوب: أجاب 500 عميل، وقال 62 بالمئة منهم إنهم راضون.
p × (1 − p) = 0.62 × 0.38 = 0.2356
÷ n         = 0.2356 / 500 = 0.0004712
√           = 0.0217
× z         = 1.96 × 0.0217 = 0.0425   →   ±4.3 نقطة

فترة الثقة 95%: من 57.7% إلى 66.3%
اعرضها هكذا: «62 بالمئة راضون (±4.3 نقطة، n = 500)». وn هو عدد من أجابوا عن هذا السؤال، لا عدد المدعوين، ولكل شريحة هامشها الخاص الأوسع لأن n فيها أصغر. تُجري حاسبة هامش الخطأ هذا الحساب لأي عينة، ويعكسه دليل حجم العينة ليصل إلى عدد الردود التي تحتاجها. ويقدم مدخل هامش الخطأ في المسرد التعريف المختصر.
كيف تقارن بين نسبتين: اختبار z لنسبتين
لمقارنة نسب مئوية من مجموعتين مستقلتين (موجتين، أو منطقتين، أو باقتين)، اختبر الفرق نفسه. يجمع اختبار z لنسبتين المجموعتين لتقدير الضجيج، ثم يحسب عدد الأخطاء المعيارية التي تفصل بين النتيجتين:
p_pool = (x1 + x2) / (n1 + n2)
SE     = √( p_pool × (1 − p_pool) × (1/n1 + 1/n2) )
z      = (p2 − p1) / SE

x = عدد من أعطوا الإجابة، n = عدد من أجابوا عن السؤال
|z| ≥ 1.96   →   دال عند مستوى ثقة 95% (p < 0.05)
مثال محسوب: استبيان نبض يطرح سؤال نعم أو لا نفسه كل ربيع وكل خريف.
في الربيع أجاب 232 موظفًا من 400 بنعم (58 بالمئة)، وفي الخريف أجاب 288 من 450 (64 بالمئة).
p1     = 232 / 400 = 0.580
p2     = 288 / 450 = 0.640
p_pool = (232 + 288) / (400 + 450) = 520 / 850 = 0.612
SE     = √( 0.612 × 0.388 × (1/400 + 1/450) )
       = √( 0.2375 × 0.004722 ) = √0.0011215 = 0.0335
z      = (0.640 − 0.580) / 0.0335 = 1.79
القيمة z = 1.79 أقل من 1.96، لذا فإن ارتفاع النقاط الست ليس دالًا عند مستوى ثقة 95 بالمئة (القيمة الاحتمالية ثنائية الطرف = 0.07). وفترة الثقة 95 بالمئة للتغيّر، باستخدام الخطأ المعياري غير المجمّع √(p1(1 − p1)/n1 + p2(1 − p2)/n2) = 0.0335، هي 6 ± 6.6 نقطة، أي من −0.6 إلى +12.6. معظم هذا المدى موجب، لكنه يشمل احتمال عدم حدوث أي تغيّر. والخلاصة الأمينة هي: «ارتفاع 6 نقاط، ضمن ما يمكن أن ينتجه ضجيج المعاينة؛ وسنتحقق منه مجددًا في الموجة القادمة».
والفرق نفسه البالغ 6 نقاط مع 1,500 رد في كل موجة يعطي z = 3.37 (p < 0.001). فحجم العينة هو ما يرفع الفرق الحقيقي فوق مستوى الضجيج. وحين تتقارب المجموعتان في الحجم، يكون هامش الخطأ للفرق نحو 1.4 مرة من هامش كل نسبة على حدة.
تداخل الفترات ليس هو الاختبار
تداخل هامشي خطأ لا يثبت أن الفرق مجرد ضجيج. فمع 1,000 رد في كل مجموعة، تتداخل النسبتان 50.0 بالمئة (الفترة من 46.9 إلى 53.1) و54.5 بالمئة (الفترة من 51.4 إلى 57.6)، ومع ذلك يعطي اختبار z القيمة z = 2.01 وp = 0.044، أي فرقًا دالًا. اختبر الفرق، ولا تحكم عليه بالعين من فترتين.
مقارنة NPS بين مجموعتين
هامش صافي نقاط الترويج (NPS) أوسع من هامش نسبة مئوية واحدة، لأنه يطرح نسبة من أخرى. إذا كانت P وD نسبتي المروجين والمنتقدين بصيغة عشرية:
SE(NPS)  = √( (P + D − (P − D)²) / n )
SE(diff) = √( SE_A² + SE_B² )
z        = (NPS_A − NPS_B) / SE(diff)        NPS بصيغة عشرية: 25 → 0.25
يطرح متجران السؤال المعياري بعد كل عملية شراء.
لدى المتجر A 300 رد، منها 45 بالمئة مروجون (9 أو 10) و20 بالمئة منتقدون (من 0 إلى 6)، فيكون NPS مساويًا 25. ولدى المتجر B 250 ردًا، منها 38 بالمئة مروجون و24 بالمئة منتقدون، فيكون NPS مساويًا 14.
SE_A     = √( (0.45 + 0.20 − 0.25²) / 300 ) = √( 0.5875 / 300 ) = 0.0443
SE_B     = √( (0.38 + 0.24 − 0.14²) / 250 ) = √( 0.6004 / 250 ) = 0.0490
SE(diff) = √( 0.0443² + 0.0490² ) = 0.0660
z        = 0.11 / 0.0660 = 1.67
فرق NPS البالغ 11 نقطة مع هاتين العينتين ليس دالًا (p = 0.10)، وتمتد فترة الثقة 95 بالمئة للفرق من نحو −2 إلى +24 نقطة. بل إن NPS كل متجر وحده يحمل هامشًا يقارب ±9 نقاط.
لماذا تضلّل الشرائح الصغيرة
تنتج الشرائح الصغيرة أكثر الأرقام لفتًا للنظر وأقلها موثوقية. افترض أن 15 من 18 شخصًا في فريق راضون، و13 من 22 في فريق آخر. فرق من 24 نقطة يبدو اكتشافًا:
| الفريق | الراضون | النسبة | مدى 95% (فترة ويلسون) |
|---|---|---|---|
| A | 15 من 18 | 83% | من 61% إلى 94% |
| B | 13 من 22 | 59% | من 39% إلى 77% |
يتداخل المديان تداخلًا كبيرًا، واختبار فيشر الدقيق، وهو الاختبار المناسب لأعداد بهذا الصغر، يعطي p = 0.17 لهذا الفرق. ليس دالًا. ثم إن اختبار z غير موثوق هنا أصلًا: فقاعدة عملية شائعة تشترط وجود 10 أشخاص على الأقل لكل إجابة في كل مجموعة، وليس في الفريق A إلا 3 غير راضين. مع الأعداد الصغيرة، استخدم اختبار فيشر الدقيق وفترات ويلسون.
وتتكدّس المجموعات الصغيرة أيضًا في أعلى أي ترتيب وأسفله، لأن نسبها تتأرجح أكثر من غيرها. ففي ترتيب يضم 20 فريقًا، كثيرًا ما تكون أفضل نتيجة وأسوأ نتيجة من نصيب أصغر الفرق. وحين تبني جدولًا تقاطعيًا، تكون كل خلية فيه عينة صغيرة قائمة بذاتها. ثلاث عادات تحميك:
- ضع n بجانب كل نسبة مئوية لشريحة.
- حدّد حدًا أدنى لحجم المجموعة قبل أن تفتح النتائج، وأخفِ بلون باهت أو ادمج المجموعات التي لا تبلغه.
- تعامل مع النتيجة اللافتة من مجموعة صغيرة على أنها سؤال للموجة القادمة أو لحوار، لا على أنها استنتاج.
المقارنات المتعددة: اختبر 20 فرقًا وسيبدو أحدها حقيقيًا على الأرجح
لكل اختبار عند مستوى ثقة 95 بالمئة احتمال إنذار كاذب قدره 5 بالمئة، وتتراكم هذه الاحتمالات. قارن 20 شريحة أو سؤالًا مستقلًا لا يوجد بينها فرق حقيقي، وسيكون احتمال أن يُظهر واحد منها على الأقل فرقًا «دالًا» 64 بالمئة.
| عدد الاختبارات | احتمال نتيجة إيجابية كاذبة واحدة على الأقل | عتبة بونفيروني لكل اختبار |
|---|---|---|
| 1 | 5% | p < 0.05 |
| 5 | 23% | p < 0.01 |
| 10 | 40% | p < 0.005 |
| 20 | 64% | p < 0.0025 |
العمود الثاني يساوي 1 − 0.95^k لعدد k من الاختبارات المستقلة. ثلاث طرق لإبقاء الإنذارات الكاذبة خارج التقرير:
- حدّد المقارنات قبل أن ترى البيانات، واكتبها في خطة التحليل. وكل ما عداها استكشاف.
- حين تُجري اختبارات كثيرة، شدّد العتبة. تقسم طريقة بونفيروني 0.05 على عدد الاختبارات؛ فلعشرين اختبارًا تصبح العتبة p < 0.0025، أي |z| ≥ 3.02. وطريقة هولم صيغة تدريجية أقل صرامة، أما طريقة بنجاميني وهوشبرغ فتضبط معدل الاكتشافات الكاذبة، وهي تناسب القوائم الاستكشافية الطويلة.
- تعامل مع أي اكتشاف غير مخطط له على أنه فرضية، وتحقق منه في الموجة القادمة قبل أن تتصرف بناءً عليه.
الأهمية العملية مقابل الدلالة الإحصائية
تقول الدلالة الإحصائية إن الفرق على الأرجح ليس ضجيجًا، لكنها لا تقول إن الفرق مهم. فمع 40,000 رد في كل مجموعة، تعطي 71 بالمئة مقابل 72 بالمئة القيمة z = 3.13 وp = 0.002: نتيجة دالة، ولا أثر لها على الأرجح في أي قرار. وفي الاتجاه المعاكس، قد يفشل فرق من 15 نقطة في تجربة أولية على 40 شخصًا في اجتياز الاختبار، ويظل جديرًا بنظرة أدق.
حدّد قبل التحليل حجم التغيّر الذي يدفعك إلى التصرف، مثل «5 نقاط في عبء العمل»، ثم اقرأ كل نتيجة في ضوء المعيارين معًا:
| دال إحصائيًا؟ | يبلغ عتبة التصرف لديك على الأقل؟ | ماذا تفعل |
|---|---|---|
| نعم | نعم | تصرّف، وبيّن مدى ثقتك |
| نعم | لا | اعرضه على أنه حقيقي لكنه صغير؛ ولا تُعِد التنظيم من أجله |
| لا | نعم | لا تجزم به؛ اجمع ردودًا أكثر أو اختبره مباشرة |
| لا | لا | أعلن عدم وجود تغيّر ذي معنى |
اعرض الفرق مع فترته («ارتفاع 6 نقاط، وفترة الثقة 95 بالمئة من −0.6 إلى +12.6») بدلًا من الاكتفاء بعبارة «دال» أو «غير دال»، حتى يستطيع القارئ الحكم على المسألتين معًا. ويوضح دليل عرض نتائج الاستبيانات كيف تضع ذلك في رسم بياني.
متى لا يستطيع الاستبيان الإجابة عن السؤال
بعض الأسئلة تقع خارج ما يستطيع أي اختبار على بيانات الاستبيان حسمه، مهما كان عدد الردود.
- لا يستطيع الاستبيان أن يبيّن سبب حدوث أمر ما. فقد يُظهر أن العملاء الذين استخدموا الدردشة المباشرة أكثر رضا، لكن ربما كان العملاء الراضون ببساطة هم من يكلّفون أنفسهم عناء الدردشة. ولاختبار سبب ما، غيّر شيئًا واحدًا لنصف يُختار عشوائيًا وقارن، كما في اختبار A/B.
- لا يستطيع تصحيح أثر من لم يُجيبوا. فكل معادلة في هذه الصفحة تفترض عينة عشوائية. وإذا أجاب 12 بالمئة من العملاء وكانوا الأكثر تفاعلًا، فقد يتجاوز التحيز هامش الخطأ، ولا يكشفه أي اختبار. قارن المجيبين بالقائمة الكاملة في الحقول التي تملكها أصلًا (الباقة، والمنطقة، ومدة الاشتراك)، ونظّف البيانات قبل أن تختبر أي شيء.
- لا يجد ما يختبره حين يُجيب الجميع. فإذا أجاب جميع أعضاء فريق من 85 شخصًا، فلا يوجد خطأ معاينة: الفرق بين مجموعتين هو الفرق كما هو. ويبقى السؤال هل هو كبير بما يكفي للتصرف، وهل يستمر.
- لا يستطيع الفصل بين تغيّر حقيقي وتغيّر في المنهج. فإذا تغيّرت الصياغة أو القناة أو الجمهور بين موجتين، فإن الفرق يخلط الأمرين.
- لا يقيس الأحداث النادرة جيدًا. فالأمر الذي يمس 1 بالمئة من الناس يظهر في نحو 3 ردود من 300. استخدم البيانات التشغيلية بدلًا من ذلك.
- لا يضمن السلوك. فالنية المعلنة للشراء أو التجديد أو المغادرة مؤشر ضعيف على ما يفعله الناس فعلًا، لذا قارنها بما فعلوه لاحقًا.
الأخطاء الشائعة
- وصف التغيّر بأنه «ارتفاع» أو «انخفاض» دون اختبار. أجرِ اختبار z أو اعرض فترة الثقة للفرق.
- الحكم على الفرق بناءً على تداخل هامشين أو عدمه. اختبر الفرق مباشرة.
- عرض نسب مئوية لشرائح من نحو اثني عشر شخصًا. أظهر n، وحدّد حدًا أدنى، وادمج المجموعات الصغيرة.
- اختبار كل خلية في جدول تقاطعي وعرض ما خرج منها دالًا. خطّط للمقارنات أو صحّح للاختبارات المتعددة.
- اعتبار p < 0.05 دليلًا على «الأهمية». اذكر حجم الفرق وهل يتجاوز عتبة التصرف لديك.
- استخدام عدد المدعوين على أنه n. استخدم عدد من أجابوا عن السؤال.
- معاملة استطلاع مفتوح قائم على المشاركة الطوعية كأنه عينة عشوائية. وضّح نوع العينة وما لا تستطيع تمثيله.
كيف تفعل ذلك في Claform
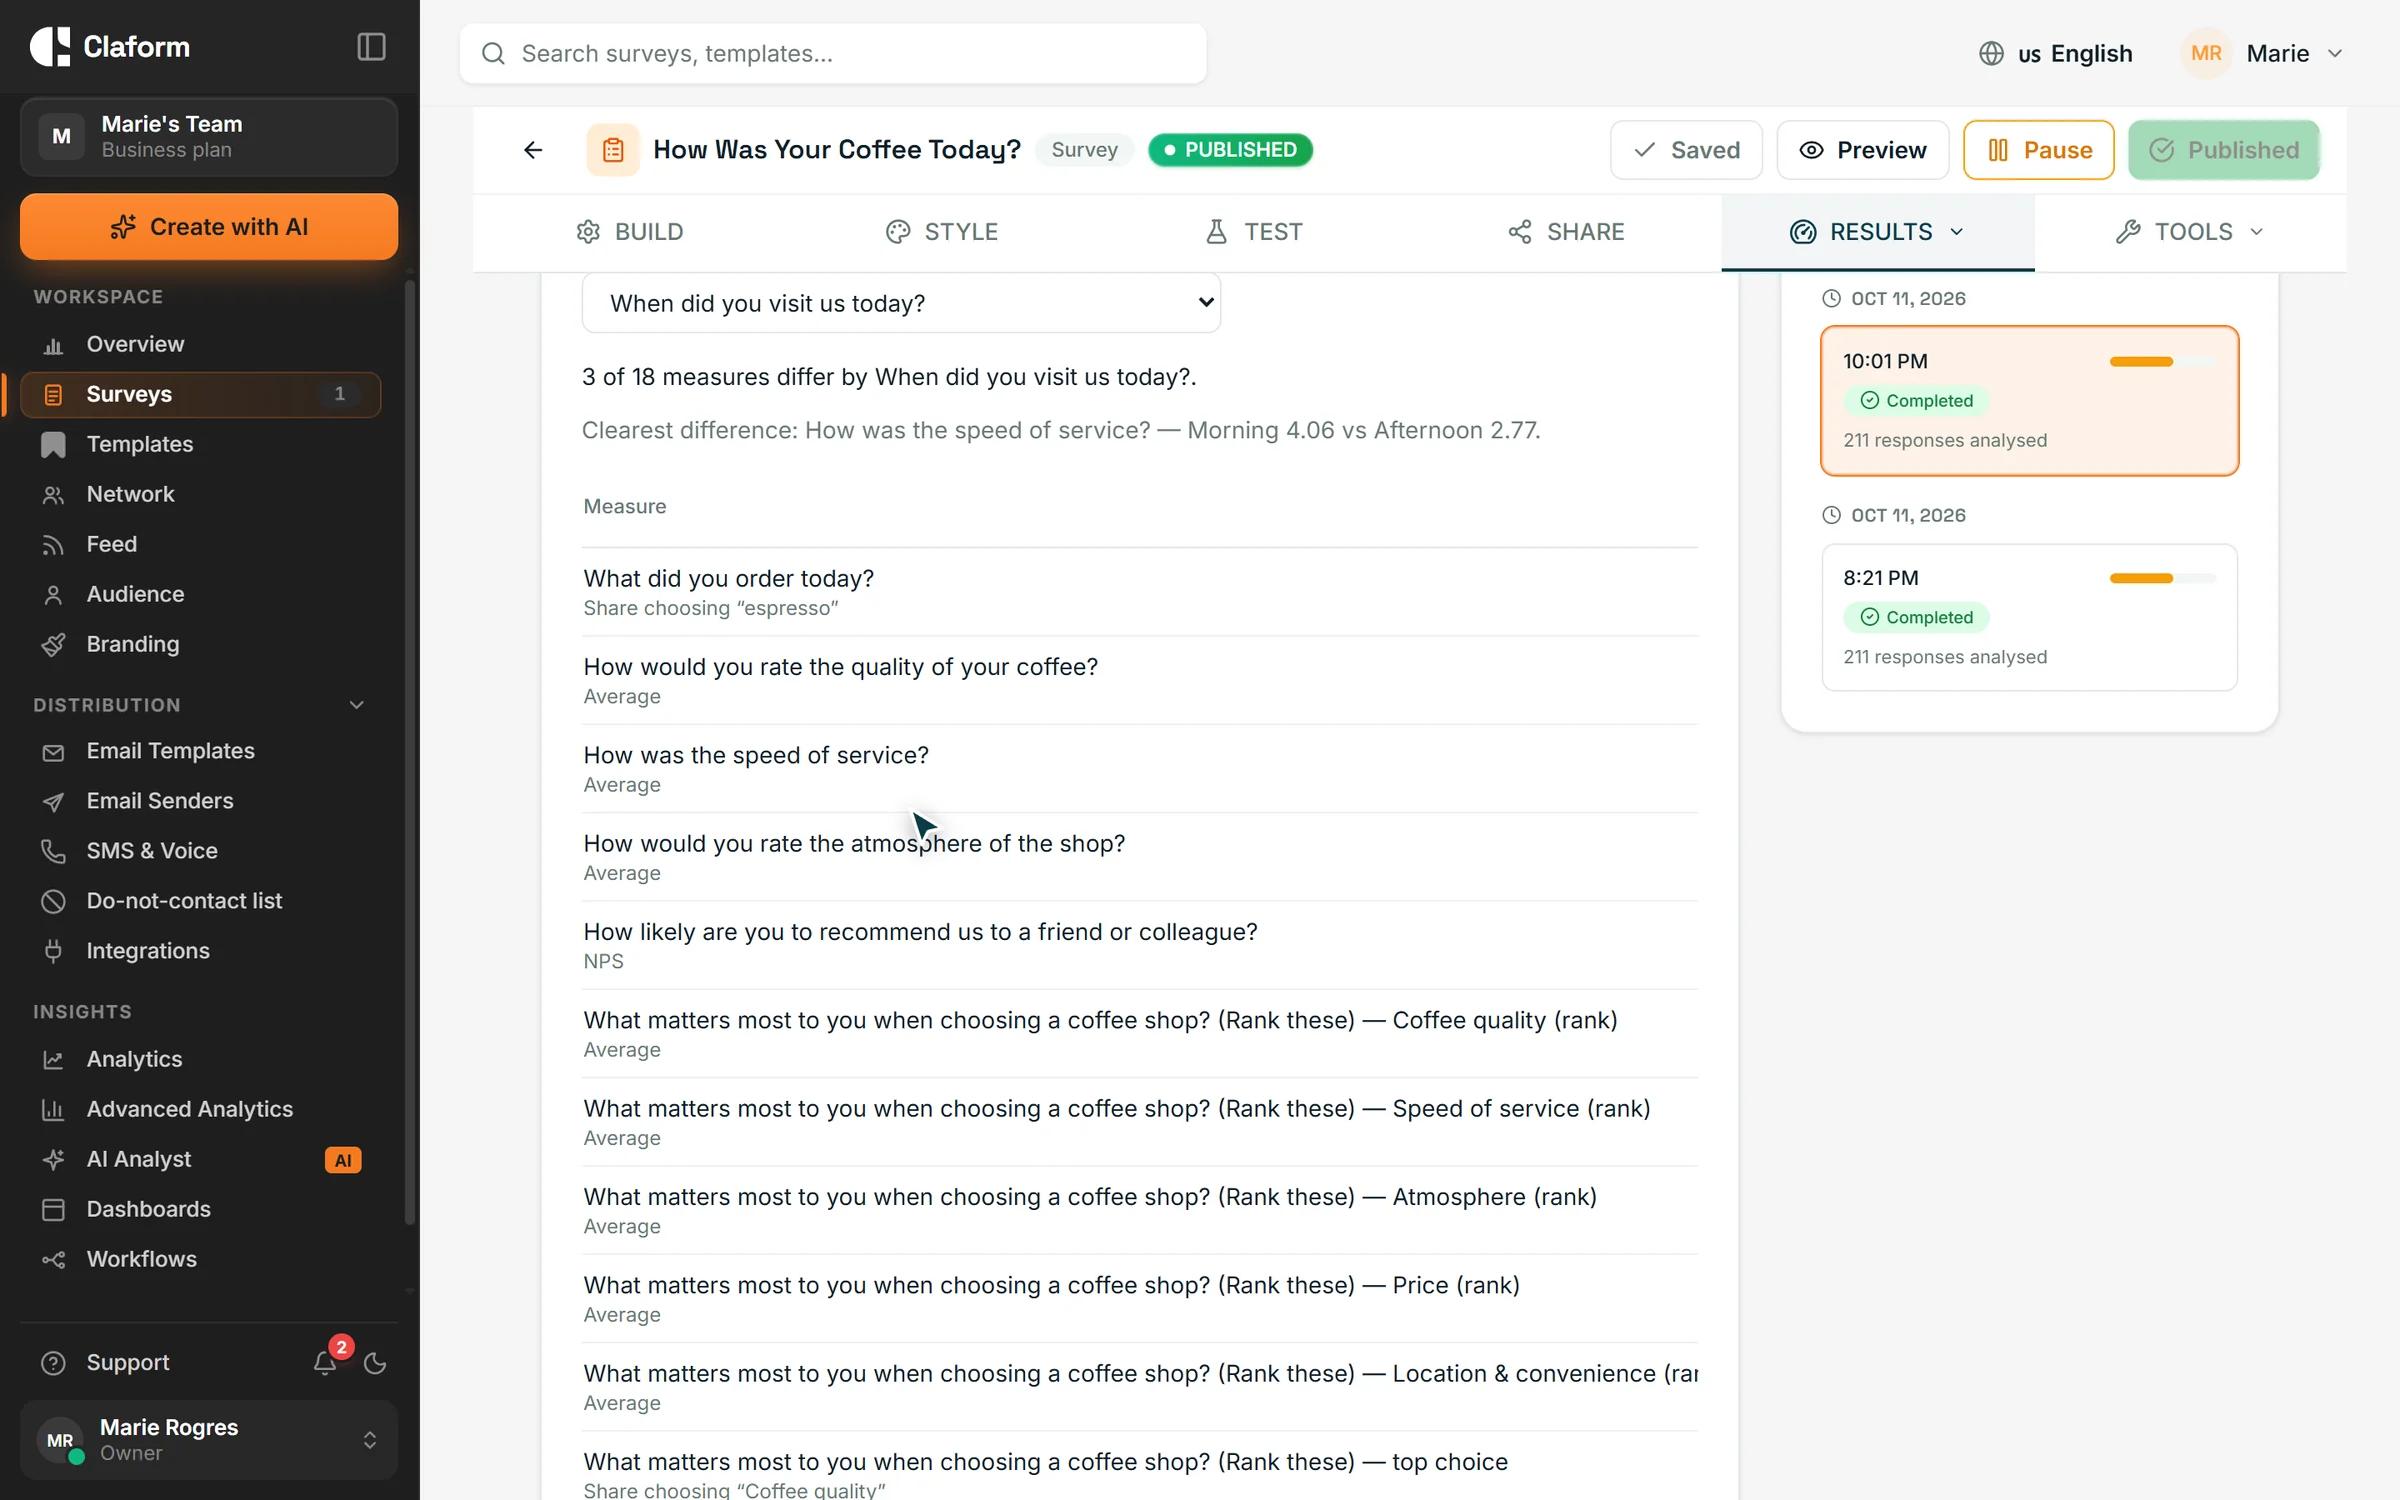
تطبّق حاسبة هامش الخطأ وحاسبة حجم العينة المعادلات الواردة في هذه الصفحة، بما في ذلك تصحيح المجتمع المحدود للمجتمعات الصغيرة. وفي AI Analyst، المتاح في باقة Professional وما فوقها، تقسّم ميزة المقارنة حسب سؤال كل مقياس وفق سؤال واحد، مثل الموقع أو الباقة، وتضع علامة على المجموعات الصغيرة، ولا تعرض المجموعات التي تقل ردودها عن عشرة. ويحسب التحليل المعمّق اختبارات مربع كاي واختبارات t وتحليل التباين (ANOVA) والارتباطات مع تصحيح للاختبارات المتعددة، ويعرض أحجام الأثر مع فترات ثقة 95 بالمئة، وينبّه إلى العينات الصغيرة قبل أن يكتب توصياته، وترتبط كل توصية بالإحصاء الذي تستند إليه.
الأسئلة الشائعة
ما القيمة الاحتمالية التي تُعدّ دالة في الاستبيان؟
جرى العرف على p < 0.05، وهو ما يقابل مستوى ثقة 95 بالمئة. إنه عرف وليس قانونًا. استخدم 0.01 حين يكون الإنذار الكاذب مكلفًا أو حين تُجري اختبارات كثيرة، وتعامل مع النتائج بين 0.05 و0.10 على أنها جديرة بالمتابعة لا على أنها اكتشافات. واذكر دائمًا حجم الفرق إلى جانب القيمة الاحتمالية.
كم ردًا أحتاج لاكتشاف فرق بين مجموعتين؟
أكثر مما تحتاجه لتقدير واحد. فلاكتشاف تغيّر من 58 إلى 64 بالمئة عند مستوى ثقة 95 بالمئة وقوة اختبار 80 بالمئة، أي باحتمال 80 بالمئة لالتقاط فرق حقيقي بهذا الحجم، تحتاج إلى نحو 1,034 ردًا في كل مجموعة. وتقليص الفرق الذي تريد اكتشافه إلى النصف يضاعف حجم العينة أربع مرات تقريبًا.
هل يمكنني استخدام اختبار t مع متوسطات مقاييس التقييم؟
نعم. لمقارنة متوسط التقييمات بين مجموعتين، اختبار t لويلش هو الخيار المعتاد، ومع بضع عشرات من الردود في كل مجموعة يؤدي أداءً جيدًا على مقاييس من خمس نقاط. واعرض أيضًا التوزيع أو نسبة أعلى خيارين (top-two-box)، لأن تساوي المتوسطات قد يخفي توزيعات مختلفة جدًا. ولثلاث مجموعات أو أكثر، استخدم تحليل التباين (ANOVA).
هل التغيّر بمقدار 5 نقاط في NPS دال إحصائيًا؟
غالبًا لا، إلا إذا كانت العينتان كبيرتين. فمؤشر NPS يطرح نسبة من أخرى، ولذلك يكون هامش خطئه أوسع من هامش نسبة واحدة: نحو ±9 نقاط مع 300 رد وNPS يساوي 25. استخدم معادلة الخطأ المعياري لـ NPS الواردة في هذه الصفحة، أو اختبر نسبتي المروجين والمنتقدين كلًا على حدة.
ما الفرق بين هامش الخطأ والدلالة الإحصائية؟
يصف هامش الخطأ عدم اليقين المحيط بنتيجة واحدة. أما اختبار الدلالة فيسأل هل الفرق بين نتيجتين أكبر من عدم اليقين المشترك بينهما. وللفرق هامشه الخاص الأوسع، لذا قارن بين نتيجتين باختبار، لا بالتحقق مما إذا كان هامشاهما الفرديان متداخلين.