Statistische Signifikanz in Umfragen: echter Unterschied?
Echte Veränderung oder Rauschen: Fehlerspanne, Zwei-Stichproben-z-Test für Anteile mit Rechenweg, kleine Segmente, Mehrfachvergleiche und praktische Relevanz.
Auf dieser Seite
- Was statistische Signifikanz bei Umfrageergebnissen bedeutet
- Fehlerspanne eines Anteils
- Zwei Prozentwerte vergleichen: der z-Test für zwei Anteile
- Warum kleine Segmente in die Irre führen
- Mehrfachvergleiche: Testen Sie 20 Unterschiede, wirkt vermutlich einer echt
- Praktische und statistische Signifikanz
- Wann eine Umfrage die Frage nicht beantworten kann
- Häufige Fehler
- So geht das in Claform
- Häufig gestellte Fragen
Ein Unterschied zwischen zwei Umfrageergebnissen ist statistisch signifikant, wenn er größer ist, als der Zufall der Stichprobenziehung allein plausibel erzeugen würde. Bei zwei Prozentwerten prüfen Sie das mit einem z-Test für zwei Anteile: Teilen Sie den Unterschied durch seinen Standardfehler und vergleichen Sie das Ergebnis mit 1,96, der Schwelle für 95 Prozent Konfidenz. Ein Anstieg von 58 auf 64 Prozent bei rund 400 Antworten pro Welle ergibt z = 1,79 und reicht damit nicht.
Dieser Leitfaden behandelt die Fehlerspanne eines Prozentwerts, den Test für zwei, NPS-Unterschiede, kleine Segmente, viele Vergleiche auf einmal und die Fragen, die kein Test beantworten kann.
Was statistische Signifikanz bei Umfrageergebnissen bedeutet
Statistische Signifikanz beantwortet eine eng gefasste Frage: Wenn es in der Grundgesamtheit keinen echten Unterschied gäbe, wie oft entstünde ein so großer Unterschied allein dadurch, wer zufällig geantwortet hat? Diese Wahrscheinlichkeit ist der p-Wert. Liegt er unter 0,05, gilt das Ergebnis als signifikant bei 95 Prozent Konfidenz.
Er sagt Ihnen nicht, ob der Unterschied groß genug ist, um eine Rolle zu spielen, ob die Umfrage die richtigen Menschen erreicht hat oder warum der Unterschied besteht. Diese Fragen kommen weiter unten, und sie entscheiden mehr als der p-Wert.
Fehlerspanne eines Anteils
Die Fehlerspanne ist der Bereich um einen Prozentwert, den der Zufall der Stichprobe erklären kann. Für einen Anteil aus einer einfachen Zufallsstichprobe gilt:
MOE = z × √( p × (1 − p) / n )

z = 1.96 für 95% Konfidenz (1.645 für 90%, 2.576 für 99%)
p = der berichtete Anteil als Dezimalzahl
n = vollständige Antworten auf diese Frage
Rechenbeispiel: 500 Kundinnen und Kunden haben geantwortet, 62 Prozent sind zufrieden.
p × (1 − p) = 0.62 × 0.38 = 0.2356
÷ n         = 0.2356 / 500 = 0.0004712
√           = 0.0217
× z         = 1.96 × 0.0217 = 0.0425   →   ±4.3 Punkte

95%-Intervall: 57.7% bis 66.3%
Berichten Sie das als „62 Prozent zufrieden (±4,3 Punkte, n = 500)“. n ist die Zahl derer, die diese Frage beantwortet haben, nicht die Zahl der Eingeladenen, und jedes Segment hat seine eigene, breitere Spanne, weil sein n kleiner ist. Der Fehlerspannen-Rechner rechnet das für jede Stichprobe, und der Leitfaden zur Stichprobengröße rechnet rückwärts bis zur Zahl der Antworten, die Sie brauchen. Der Glossareintrag Fehlerspanne enthält die Kurzdefinition.
Zwei Prozentwerte vergleichen: der z-Test für zwei Anteile
Um Prozentwerte aus zwei unabhängigen Gruppen zu vergleichen (zwei Wellen, zwei Regionen, zwei Tarife), testen Sie den Unterschied selbst. Der z-Test für zwei Anteile fasst beide Gruppen zusammen, um das Rauschen zu schätzen, und fragt dann, wie viele Standardfehler die Ergebnisse auseinanderliegen:
p_pool = (x1 + x2) / (n1 + n2)
SE     = √( p_pool × (1 − p_pool) × (1/n1 + 1/n2) )
z      = (p2 − p1) / SE

x = Personen mit dieser Antwort, n = Personen, die die Frage beantwortet haben
|z| ≥ 1.96   →   signifikant bei 95% Konfidenz (p < 0.05)
Rechenbeispiel: Eine Pulsbefragung stellt im Frühjahr und im Herbst dieselbe Ja-Nein-Frage.
Im Frühjahr antworteten 232 von 400 Beschäftigten mit Ja (58 Prozent), im Herbst 288 von 450 (64 Prozent).
p1     = 232 / 400 = 0.580
p2     = 288 / 450 = 0.640
p_pool = (232 + 288) / (400 + 450) = 520 / 850 = 0.612
SE     = √( 0.612 × 0.388 × (1/400 + 1/450) )
       = √( 0.2375 × 0.004722 ) = √0.0011215 = 0.0335
z      = (0.640 − 0.580) / 0.0335 = 1.79
Ein z von 1,79 liegt unter 1,96, der Anstieg um 6 Punkte ist also bei 95 Prozent Konfidenz nicht signifikant (zweiseitiger p-Wert = 0,07). Das 95-Prozent-Intervall für die Veränderung, berechnet mit dem nicht gepoolten Standardfehler √(p1(1 − p1)/n1 + p2(1 − p2)/n2) = 0,0335, beträgt 6 ± 6,6 Punkte, also von −0,6 bis +12,6. Der größte Teil dieses Bereichs ist positiv, er schließt aber auch keine Veränderung ein. Die ehrliche Zusammenfassung lautet: „6 Punkte höher, im Rahmen dessen, was Stichprobenrauschen erzeugen kann; wir prüfen es in der nächsten Welle erneut.“
Derselbe Unterschied von 6 Punkten mit 1.500 Antworten pro Welle ergibt z = 3,37 (p < 0,001). Die Stichprobengröße hebt einen echten Unterschied über das Rauschen. Sind beide Gruppen ähnlich groß, ist die Fehlerspanne des Unterschieds etwa 1,4-mal so groß wie die Spanne jedes einzelnen Prozentwerts.
Überlappende Intervalle sind nicht der Test
Zwei Fehlerspannen, die sich überlappen, beweisen nicht, dass ein Unterschied Rauschen ist. Mit 1.000 Antworten pro Gruppe überlappen sich 50,0 Prozent (Intervall 46,9 bis 53,1) und 54,5 Prozent (Intervall 51,4 bis 57,6), dennoch ergibt der z-Test z = 2,01 und p = 0,044, also einen signifikanten Unterschied. Testen Sie den Unterschied, statt ihn nach Augenmaß aus zwei Intervallen abzulesen.
NPS zwischen zwei Gruppen vergleichen
Der Net Promoter Score hat eine breitere Spanne als ein einzelner Prozentwert, weil er einen Anteil von einem anderen abzieht. Mit P und D als Anteilen der Promotoren und Kritiker, als Dezimalzahlen:
SE(NPS)  = √( (P + D − (P − D)²) / n )
SE(diff) = √( SE_A² + SE_B² )
z        = (NPS_A − NPS_B) / SE(diff)        NPS als Dezimalzahl: 25 → 0.25
Zwei Filialen stellen nach jedem Einkauf die Standardfrage.
Filiale A hat 300 Antworten, 45 Prozent Promotoren (9 oder 10) und 20 Prozent Kritiker (0 bis 6), also einen NPS von 25. Filiale B hat 250 Antworten, 38 Prozent Promotoren und 24 Prozent Kritiker, also einen NPS von 14.
SE_A     = √( (0.45 + 0.20 − 0.25²) / 300 ) = √( 0.5875 / 300 ) = 0.0443
SE_B     = √( (0.38 + 0.24 − 0.14²) / 250 ) = √( 0.6004 / 250 ) = 0.0490
SE(diff) = √( 0.0443² + 0.0490² ) = 0.0660
z        = 0.11 / 0.0660 = 1.67
Ein NPS-Unterschied von 11 Punkten ist bei diesen Stichproben nicht signifikant (p = 0,10), und das 95-Prozent-Intervall für den Unterschied reicht von etwa −2 bis +24 Punkten. Schon der NPS jeder einzelnen Filiale hat eine Spanne von etwa ±9 Punkten.
Warum kleine Segmente in die Irre führen
Kleine Segmente liefern die auffälligsten und die am wenigsten verlässlichen Zahlen. Angenommen, in einem Team sind 15 von 18 Personen zufrieden, in einem anderen 13 von 22. Ein Unterschied von 24 Punkten sieht nach einem Befund aus:
| Team | Zufrieden | Anteil | 95-%-Bereich (Wilson-Intervall) |
|---|---|---|---|
| A | 15 von 18 | 83 % | 61 % bis 94 % |
| B | 13 von 22 | 59 % | 39 % bis 77 % |
Die Bereiche überlappen sich stark, und der exakte Test nach Fisher, der richtige Test für so kleine Fallzahlen, ergibt für den Unterschied p = 0,17. Nicht signifikant. Der z-Test ist hier ohnehin unzuverlässig: Eine gängige Faustregel verlangt mindestens 10 Personen pro Antwort in jeder Gruppe, und in Team A sind nur 3 nicht zufrieden. Verwenden Sie bei kleinen Fallzahlen den exakten Test nach Fisher und Wilson-Intervalle.
Kleine Gruppen drängen sich außerdem am oberen und unteren Ende jeder Rangliste, weil ihre Prozentwerte am stärksten schwanken. In einer Rangliste von 20 Teams gehören der beste und der schlechteste Wert oft den kleinsten Teams. Wenn Sie eine Kreuztabelle erstellen, ist jede Zelle eine eigene kleine Stichprobe. Drei Gewohnheiten schützen Sie:
- Schreiben Sie n neben jeden Segmentprozentwert.
- Legen Sie eine Mindestgruppengröße fest, bevor Sie die Ergebnisse öffnen, und blenden Sie kleinere Gruppen grau ein oder fassen Sie sie zusammen.
- Behandeln Sie ein auffälliges Ergebnis einer kleinen Gruppe als Frage für die nächste Welle oder für ein Gespräch, nicht als Schlussfolgerung.
Mehrfachvergleiche: Testen Sie 20 Unterschiede, wirkt vermutlich einer echt
Jeder Test bei 95 Prozent Konfidenz hat eine Fehlalarmwahrscheinlichkeit von 5 Prozent, und diese Wahrscheinlichkeiten summieren sich. Vergleichen Sie 20 unabhängige Segmente oder Fragen, in denen sich in Wahrheit nichts unterscheidet, zeigt mit 64 Prozent Wahrscheinlichkeit mindestens einer einen „signifikanten“ Unterschied.
| Durchgeführte Tests | Wahrscheinlichkeit für mindestens ein falsch positives Ergebnis | Bonferroni-Schwelle pro Test |
|---|---|---|
| 1 | 5 % | p < 0,05 |
| 5 | 23 % | p < 0,01 |
| 10 | 40 % | p < 0,005 |
| 20 | 64 % | p < 0,0025 |
Die zweite Spalte ist 1 − 0.95^k für k unabhängige Tests. Drei Wege, Fehlalarme aus dem Bericht herauszuhalten:
- Legen Sie die Vergleiche fest, bevor Sie die Daten sehen, und schreiben Sie sie in den Analyseplan. Alles andere ist Exploration.
- Wenn Sie viele Tests durchführen, verschärfen Sie die Schwelle. Bonferroni teilt 0,05 durch die Zahl der Tests; bei 20 Tests sind das p < 0,0025 oder |z| ≥ 3,02. Die Holm-Methode ist eine weniger strenge, schrittweise Variante, und Benjamini-Hochberg kontrolliert die False Discovery Rate, was zu langen explorativen Listen passt.
- Behandeln Sie einen ungeplanten Befund als Hypothese und prüfen Sie ihn in der nächsten Welle, bevor Sie handeln.
Praktische und statistische Signifikanz
Statistische Signifikanz sagt, dass ein Unterschied wahrscheinlich kein Rauschen ist; sie sagt nicht, dass er eine Rolle spielt. Mit 40.000 Antworten pro Gruppe ergeben 71 gegenüber 72 Prozent z = 3,13 und p = 0,002: signifikant und für jede Entscheidung mit ziemlicher Sicherheit bedeutungslos. Umgekehrt kann ein Unterschied von 15 Punkten in einem Pilot mit 40 Personen den Test verfehlen und trotzdem einen genaueren Blick verdienen.
Legen Sie vor der Analyse fest, ab welcher Veränderung Sie handeln würden, zum Beispiel „5 Punkte bei der Arbeitsbelastung“, und lesen Sie dann jedes Ergebnis gegen beide Kriterien:
| Statistisch signifikant? | Mindestens Ihre Handlungsschwelle? | Was zu tun ist |
|---|---|---|
| Ja | Ja | Handeln und sagen, wie sicher Sie sind |
| Ja | Nein | Als echt, aber klein berichten; nichts darum herum umbauen |
| Nein | Ja | Nicht behaupten; mehr Antworten sammeln oder direkt testen |
| Nein | Nein | Keine relevante Veränderung berichten |
Berichten Sie den Unterschied mit seinem Intervall („6 Punkte höher, 95-Prozent-Intervall von −0,6 bis +12,6“) statt mit einem bloßen „signifikant“ oder „nicht signifikant“, damit Leser beide Fragen zugleich beurteilen können. Der Leitfaden zum Präsentieren von Umfrageergebnissen zeigt, wie Sie das in einem Diagramm darstellen.
Wann eine Umfrage die Frage nicht beantworten kann
Manche Fragen liegen außerhalb dessen, was ein Test auf Umfragedaten klären kann, egal wie viele Antworten Sie haben.
- Eine Umfrage kann nicht zeigen, warum etwas passiert ist. Sie kann zeigen, dass Kunden, die den Live-Chat genutzt haben, zufriedener sind, aber vielleicht sind zufriedene Kunden einfach diejenigen, die sich die Mühe machen zu chatten. Um eine Ursache zu testen, ändern Sie eine Sache für eine zufällig gewählte Hälfte und vergleichen, wie in einem A/B-Test.
- Sie kann nicht ausgleichen, wer nicht geantwortet hat. Jede Formel auf dieser Seite setzt eine Zufallsstichprobe voraus. Haben 12 Prozent der Kunden geantwortet und sind das die engagiertesten, kann die Verzerrung größer sein als die Fehlerspanne, und kein Test erkennt sie. Vergleichen Sie die Antwortenden mit der vollständigen Liste anhand von Feldern, die Sie bereits haben (Tarif, Region, Zugehörigkeitsdauer), und bereinigen Sie die Daten, bevor Sie etwas testen.
- Sie hat nichts zu testen, wenn alle geantwortet haben. Haben alle 85 Personen eines Teams geantwortet, gibt es keinen Stichprobenfehler: Der Unterschied zwischen zwei Gruppen ist der Unterschied. Offen bleibt, ob er groß genug ist, um zu handeln, und ob er anhält.
- Sie kann eine echte Veränderung nicht von einer Methodenänderung trennen. Haben sich Formulierung, Kanal oder Zielgruppe zwischen zwei Wellen geändert, vermischt der Unterschied beides.
- Sie misst seltene Ereignisse schlecht. Etwas, das 1 Prozent der Menschen betrifft, taucht in etwa 3 von 300 Antworten auf. Nutzen Sie stattdessen operative Daten.
- Sie kann kein Verhalten versprechen. Die erklärte Absicht zu kaufen, zu verlängern oder zu kündigen sagt das tatsächliche Verhalten schlecht voraus; prüfen Sie sie daher an dem, was die Menschen später getan haben.
Häufige Fehler
- Eine Veränderung ohne Test als „gestiegen“ oder „gesunken“ bezeichnen. Führen Sie den z-Test durch oder zeigen Sie das Intervall des Unterschieds.
- Einen Unterschied danach beurteilen, ob sich zwei Spannen überlappen. Testen Sie den Unterschied direkt.
- Prozentwerte für Segmente mit einem Dutzend Personen berichten. Zeigen Sie n, legen Sie eine Untergrenze fest und fassen Sie kleine Gruppen zusammen.
- Jede Zelle einer Kreuztabelle testen und nur die berichten, die signifikant ausfielen. Planen Sie die Vergleiche oder korrigieren Sie für Mehrfachtests.
- p < 0,05 als „wichtig“ behandeln. Nennen Sie die Größe des Unterschieds und ob er Ihre Handlungsschwelle überschreitet.
- Die Zahl der Eingeladenen als n verwenden. Verwenden Sie die Zahl derer, die die Frage beantwortet haben.
- Eine offene Umfrage mit freiwilliger Teilnahme wie eine Zufallsstichprobe behandeln. Sagen Sie, was für eine Stichprobe es ist und was sie nicht abbilden kann.
So geht das in Claform
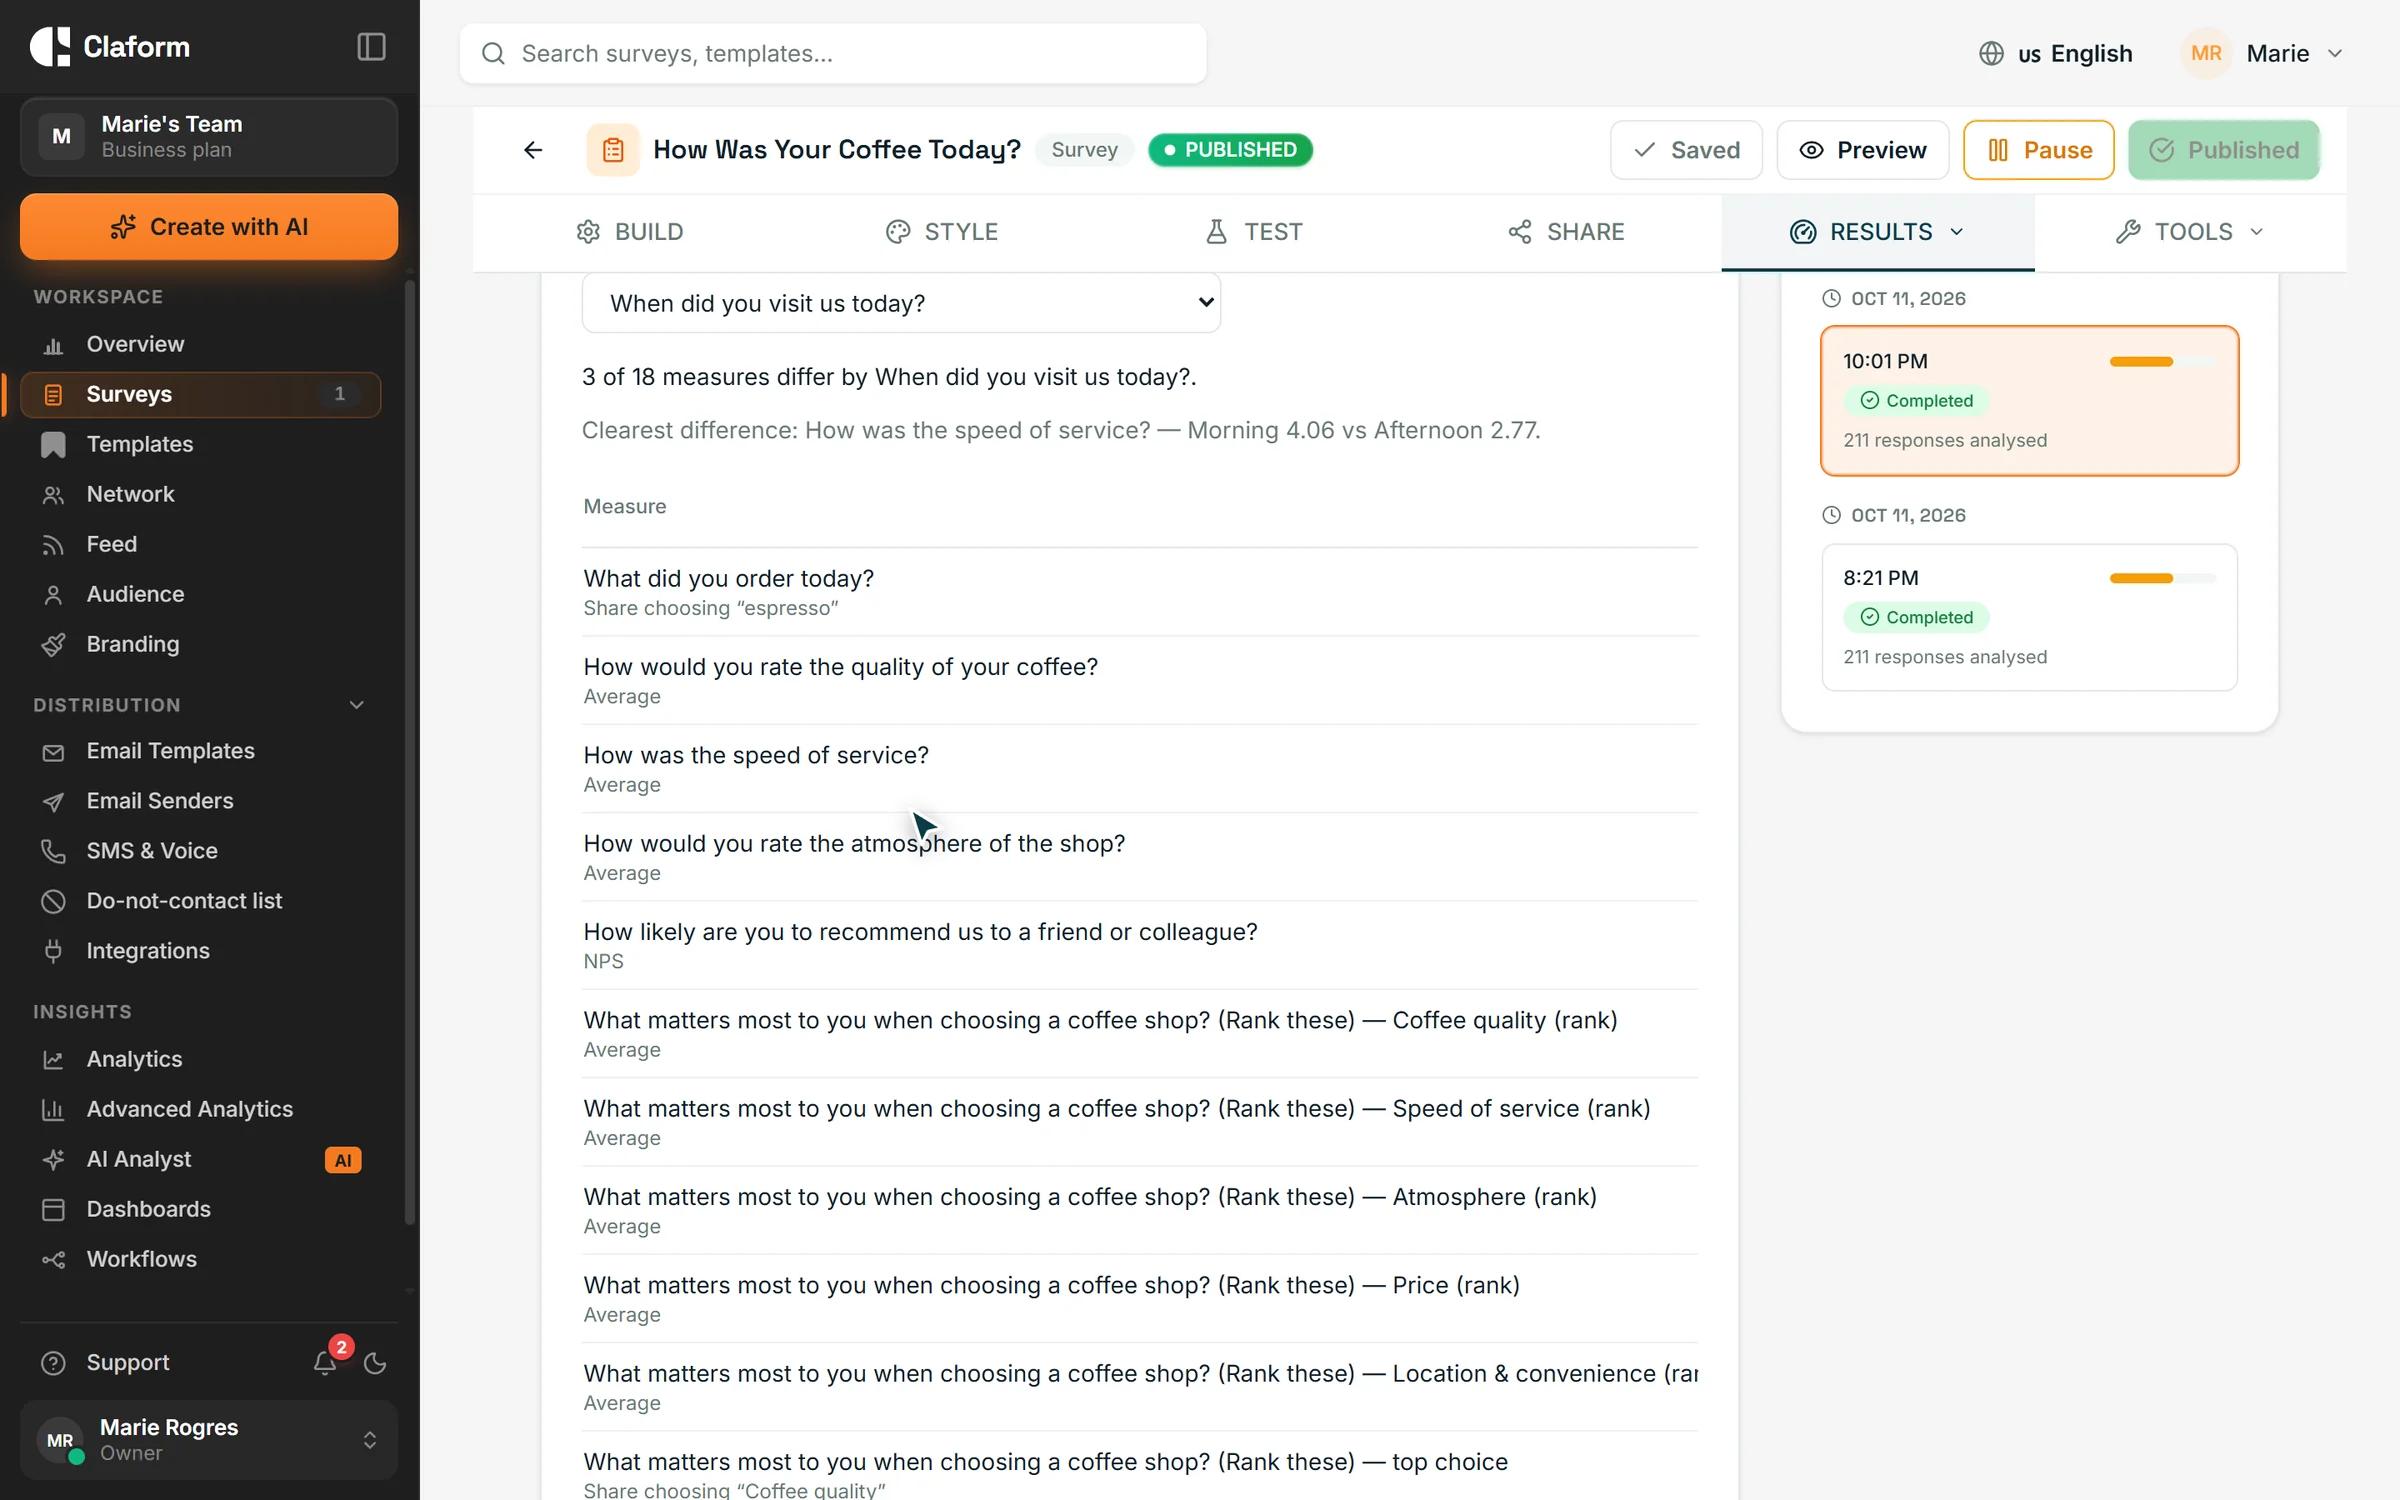
Der Fehlerspannen-Rechner und der Stichprobenrechner wenden die Formeln dieser Seite an, einschließlich der Endlichkeitskorrektur für kleine Grundgesamtheiten. Im AI Analyst, verfügbar ab dem Professional-Tarif, teilt der Vergleich nach einer Frage jede Kennzahl nach dieser Frage auf, etwa nach Standort oder Tarif, kennzeichnet kleine Gruppen und zeigt Gruppen mit weniger als zehn Antworten nicht an. Ein Tiefenanalyse-Lauf berechnet Chi-Quadrat-Tests, t-Tests, ANOVA und Korrelationen mit Korrektur für Mehrfachtests, gibt Effektstärken mit 95-Prozent-Intervallen an und markiert kleine Stichproben, bevor er Empfehlungen schreibt, die jeweils auf die zugrunde liegende Statistik verweisen.
Häufig gestellte Fragen
Welcher p-Wert gilt in einer Umfrage als signifikant?
Nach Konvention p < 0,05, was 95 Prozent Konfidenz entspricht. Das ist eine Konvention, kein Gesetz. Verwenden Sie 0,01, wenn ein Fehlalarm teuer wäre oder Sie viele Tests durchführen, und behandeln Sie Ergebnisse zwischen 0,05 und 0,10 als beobachtenswert, nicht als Befunde. Nennen Sie neben dem p-Wert immer die Größe des Unterschieds.
Wie viele Antworten brauche ich, um einen Unterschied zwischen zwei Gruppen zu erkennen?
Mehr als für eine einzelne Schätzung. Um eine Veränderung von 58 auf 64 Prozent bei 95 Prozent Konfidenz und 80 Prozent Teststärke zu erkennen, also mit 80 Prozent Wahrscheinlichkeit einen echten Unterschied dieser Größe zu finden, brauchen Sie etwa 1.034 Antworten pro Gruppe. Halbieren Sie den Unterschied, den Sie erkennen wollen, vervierfacht sich die Stichprobe ungefähr.
Kann ich einen t-Test auf Mittelwerte von Bewertungsskalen anwenden?
Ja. Um mittlere Bewertungen zwischen zwei Gruppen zu vergleichen, ist der Welch-t-Test die übliche Wahl, und mit einigen Dutzend Antworten pro Gruppe funktioniert er auf Fünf-Punkte-Skalen gut. Berichten Sie zusätzlich die Verteilung oder den Top-Two-Box-Anteil, denn gleiche Mittelwerte können sehr unterschiedliche Verteilungen verbergen. Für drei oder mehr Gruppen verwenden Sie ANOVA.
Ist eine Veränderung des NPS um 5 Punkte signifikant?
Meist nicht, außer beide Stichproben sind groß. Der NPS zieht einen Anteil von einem anderen ab, daher ist seine Fehlerspanne breiter als bei einem einzelnen Prozentwert: etwa ±9 Punkte bei 300 Antworten und einem NPS von 25. Verwenden Sie die Formel für den Standardfehler des NPS auf dieser Seite oder testen Sie die Anteile der Promotoren und Kritiker getrennt.
Was ist der Unterschied zwischen Fehlerspanne und statistischer Signifikanz?
Die Fehlerspanne beschreibt die Unsicherheit um ein einzelnes Ergebnis. Ein Signifikanztest fragt, ob der Unterschied zwischen zwei Ergebnissen größer ist als ihre gemeinsame Unsicherheit. Der Unterschied hat seine eigene, breitere Spanne. Vergleichen Sie zwei Ergebnisse deshalb mit einem Test, statt zu prüfen, ob sich ihre einzelnen Spannen überlappen.