Significativité statistique d'une enquête : écart réel ?
Distinguer un vrai changement du bruit : marge d'erreur, test z de deux proportions avec calcul détaillé, petits segments et comparaisons multiples.
Sur cette page
- Ce que signifie la significativité statistique pour des résultats d'enquête
- Marge d'erreur d'une proportion
- Comparer deux pourcentages : le test z de deux proportions
- Pourquoi les petits segments induisent en erreur
- Comparaisons multiples : testez 20 écarts et l'un d'eux paraîtra sans doute réel
- Significativité pratique et significativité statistique
- Quand une enquête ne peut pas répondre à la question
- Erreurs fréquentes
- Le faire dans Claform
- Questions fréquentes
Un écart entre deux résultats d'enquête est statistiquement significatif lorsqu'il dépasse ce que le seul hasard de l'échantillonnage pourrait plausiblement produire. Pour deux pourcentages, vérifiez-le avec un test z de deux proportions : divisez l'écart par son erreur type et comparez le résultat à 1,96, le seuil d'un niveau de confiance de 95 %. Une hausse de 58 à 64 % avec environ 400 réponses par vague donne z = 1,79, ce qui ne suffit pas.
Ce guide couvre la marge d'erreur d'un pourcentage, le test pour en comparer deux, les écarts de NPS, les petits segments, les comparaisons multiples et les questions qu'aucun test ne peut trancher.
Ce que signifie la significativité statistique pour des résultats d'enquête
La significativité statistique répond à une question précise : s'il n'existait aucune différence réelle dans la population, à quelle fréquence verrait-on un écart aussi grand du seul fait des personnes qui ont répondu ? Cette probabilité est la valeur p. Lorsqu'elle est inférieure à 0,05, le résultat est dit significatif au niveau de confiance de 95 %.
Elle ne vous dit pas si l'écart est assez grand pour compter, si l'enquête a touché les bonnes personnes, ni pourquoi l'écart existe. Ces questions sont traitées plus bas, et elles pèsent davantage dans la décision que la valeur p.
Marge d'erreur d'une proportion
La marge d'erreur est l'intervalle autour d'un pourcentage que le hasard de l'échantillonnage peut expliquer. Pour une proportion issue d'un échantillon aléatoire simple :
MOE = z × √( p × (1 − p) / n )

z = 1.96 pour un niveau de confiance de 95% (1.645 pour 90%, 2.576 pour 99%)
p = la proportion que vous publiez, en décimal
n = réponses complètes à cette question
Exemple chiffré : 500 clients ont répondu et 62 % se disent satisfaits.
p × (1 − p) = 0.62 × 0.38 = 0.2356
÷ n         = 0.2356 / 500 = 0.0004712
√           = 0.0217
× z         = 1.96 × 0.0217 = 0.0425   →   ±4.3 points

Intervalle à 95% : 57.7% à 66.3%
Présentez-le ainsi : « 62 % de satisfaits (±4,3 points, n = 500) ». Le n correspond au nombre de personnes qui ont répondu à cette question, pas au nombre d'invités, et chaque segment a sa propre marge, plus large, parce que son n est plus petit. Le calculateur de marge d'erreur fait ce calcul pour n'importe quel échantillon, et le guide sur la taille d'échantillon le prend à rebours pour obtenir le nombre de réponses nécessaires. L'entrée du glossaire marge d'erreur en donne la définition courte.
Comparer deux pourcentages : le test z de deux proportions
Pour comparer les pourcentages de deux groupes indépendants (deux vagues, deux régions, deux offres), testez l'écart lui-même. Le test z de deux proportions regroupe les deux échantillons pour estimer le bruit, puis mesure combien d'erreurs types séparent les résultats :
p_pool = (x1 + x2) / (n1 + n2)
SE     = √( p_pool × (1 − p_pool) × (1/n1 + 1/n2) )
z      = (p2 − p1) / SE

x = personnes qui donnent la réponse, n = personnes qui répondent à la question
|z| ≥ 1.96   →   significatif au niveau de confiance de 95% (p < 0.05)
Exemple chiffré : une enquête pulse pose la même question fermée chaque printemps et chaque automne.
Au printemps, 232 salariés sur 400 ont répondu oui (58 %). À l'automne, 288 sur 450 (64 %).
p1     = 232 / 400 = 0.580
p2     = 288 / 450 = 0.640
p_pool = (232 + 288) / (400 + 450) = 520 / 850 = 0.612
SE     = √( 0.612 × 0.388 × (1/400 + 1/450) )
       = √( 0.2375 × 0.004722 ) = √0.0011215 = 0.0335
z      = (0.640 − 0.580) / 0.0335 = 1.79
Un z de 1,79 est inférieur à 1,96 : la hausse de 6 points n'est donc pas significative au niveau de 95 % (valeur p bilatérale = 0,07). L'intervalle de confiance à 95 % du changement, calculé avec l'erreur type non regroupée √(p1(1 − p1)/n1 + p2(1 − p2)/n2) = 0,0335, est de 6 ± 6,6 points, soit de −0,6 à +12,6. L'essentiel de cet intervalle est positif, mais il inclut l'absence de changement. Le résumé honnête est : « en hausse de 6 points, dans les limites de ce que le bruit d'échantillonnage peut produire ; nous vérifierons à la prochaine vague ».
Le même écart de 6 points avec 1 500 réponses par vague donne z = 3,37 (p < 0,001). C'est la taille de l'échantillon qui fait émerger un écart réel au-dessus du bruit. Lorsque les deux groupes ont une taille proche, la marge d'erreur de l'écart vaut environ 1,4 fois celle de chaque pourcentage.
Des intervalles qui se chevauchent ne constituent pas le test
Deux marges d'erreur qui se chevauchent ne prouvent pas qu'un écart est du bruit. Avec 1 000 réponses dans chaque groupe, 50,0 % (intervalle de 46,9 à 53,1) et 54,5 % (intervalle de 51,4 à 57,6) se chevauchent, et pourtant le test z donne z = 2,01 et p = 0,044, un écart significatif. Testez l'écart ; ne le jugez pas à l'œil à partir de deux intervalles.
Comparer le NPS de deux groupes
Le Net Promoter Score a une marge plus large qu'un simple pourcentage, car il soustrait une proportion d'une autre. Avec P et D les proportions de promoteurs et de détracteurs, en décimal :
SE(NPS)  = √( (P + D − (P − D)²) / n )
SE(diff) = √( SE_A² + SE_B² )
z        = (NPS_A − NPS_B) / SE(diff)        NPS en décimal : 25 → 0.25
Deux magasins posent la question standard après chaque achat.
Le magasin A a 300 réponses, 45 % de promoteurs (9 ou 10) et 20 % de détracteurs (0 à 6), soit un NPS de 25. Le magasin B a 250 réponses, 38 % de promoteurs et 24 % de détracteurs, soit un NPS de 14.
SE_A     = √( (0.45 + 0.20 − 0.25²) / 300 ) = √( 0.5875 / 300 ) = 0.0443
SE_B     = √( (0.38 + 0.24 − 0.14²) / 250 ) = √( 0.6004 / 250 ) = 0.0490
SE(diff) = √( 0.0443² + 0.0490² ) = 0.0660
z        = 0.11 / 0.0660 = 1.67
Avec ces échantillons, un écart de NPS de 11 points n'est pas significatif (p = 0,10), et l'intervalle à 95 % de l'écart va d'environ −2 à +24 points. Le NPS de chaque magasin a à lui seul une marge d'environ ±9 points.
Pourquoi les petits segments induisent en erreur
Les petits segments produisent les chiffres les plus frappants et les moins fiables. Supposons que 15 personnes sur 18 soient satisfaites dans une équipe, et 13 sur 22 dans une autre. Un écart de 24 points ressemble à un résultat :
| Équipe | Satisfaits | Part | Plage à 95 % (intervalle de Wilson) |
|---|---|---|---|
| A | 15 sur 18 | 83 % | 61 % à 94 % |
| B | 13 sur 22 | 59 % | 39 % à 77 % |
Les plages se chevauchent largement, et le test exact de Fisher, le bon test pour des effectifs aussi faibles, donne p = 0,17 pour l'écart. Pas significatif. Le test z n'est de toute façon pas fiable ici : une règle empirique courante demande au moins 10 personnes pour chaque réponse dans chaque groupe, et l'équipe A ne compte que 3 personnes non satisfaites. Pour de petits effectifs, utilisez le test exact de Fisher et les intervalles de Wilson.
Les petits groupes occupent aussi le haut et le bas de tous les classements, parce que leurs pourcentages varient le plus. Dans un classement de 20 équipes, le meilleur et le pire score reviennent souvent aux plus petites. Quand vous construisez un tableau croisé, chaque cellule est son propre petit échantillon. Trois habitudes vous protègent :
- Indiquez le n à côté de chaque pourcentage de segment.
- Fixez une taille minimale de groupe avant d'ouvrir les résultats, et grisez ou regroupez les groupes qui ne l'atteignent pas.
- Traitez un résultat frappant d'un petit groupe comme une question pour la prochaine vague ou pour une discussion, pas comme une conclusion.
Comparaisons multiples : testez 20 écarts et l'un d'eux paraîtra sans doute réel
Chaque test au niveau de 95 % a 5 % de risque de fausse alerte, et ces risques s'additionnent. Comparez 20 segments ou questions indépendants où rien ne diffère réellement, et la probabilité qu'au moins un écart paraisse « significatif » est de 64 %.
| Tests réalisés | Probabilité d'au moins un faux positif | Seuil de Bonferroni par test |
|---|---|---|
| 1 | 5 % | p < 0,05 |
| 5 | 23 % | p < 0,01 |
| 10 | 40 % | p < 0,005 |
| 20 | 64 % | p < 0,0025 |
La deuxième colonne vaut 1 − 0.95^k pour k tests indépendants. Trois façons de garder les fausses alertes hors du rapport :
- Décidez des comparaisons avant de voir les données et inscrivez-les dans le plan d'analyse. Tout le reste relève de l'exploration.
- Quand vous réalisez de nombreux tests, resserrez le seuil. Bonferroni divise 0,05 par le nombre de tests ; pour 20 tests, cela donne p < 0,0025, soit |z| ≥ 3,02. La méthode de Holm en est une version séquentielle moins stricte, et Benjamini-Hochberg contrôle le taux de fausses découvertes, ce qui convient aux longues listes exploratoires.
- Traitez un résultat non prévu comme une hypothèse et vérifiez-le à la vague suivante avant d'agir.
Significativité pratique et significativité statistique
La significativité statistique indique qu'un écart n'est probablement pas du bruit ; elle ne dit pas que l'écart compte. Avec 40 000 réponses par groupe, 71 % contre 72 % donne z = 3,13 et p = 0,002 : significatif, et presque certainement sans effet sur une décision. À l'inverse, un écart de 15 points dans un pilote de 40 personnes peut échouer au test et mériter malgré tout un examen attentif.
Avant l'analyse, décidez quelle ampleur de changement vous ferait agir, par exemple « 5 points sur la charge de travail », puis lisez chaque résultat au regard des deux critères :
| Statistiquement significatif ? | Au moins votre seuil d'action ? | Que faire |
|---|---|---|
| Oui | Oui | Agissez, en précisant votre degré de certitude |
| Oui | Non | Présentez-le comme réel mais faible ; ne réorganisez rien autour |
| Non | Oui | Ne l'affirmez pas ; recueillez plus de réponses ou testez-le directement |
| Non | Non | Indiquez qu'il n'y a pas de changement notable |
Présentez l'écart avec son intervalle (« en hausse de 6 points, intervalle à 95 % de −0,6 à +12,6 ») plutôt qu'un simple « significatif » ou « non significatif », afin que le lecteur puisse juger les deux questions à la fois. Le guide pour présenter les résultats d'une enquête montre comment le faire figurer sur un graphique.
Quand une enquête ne peut pas répondre à la question
Certaines questions échappent à tout test sur des données d'enquête, quel que soit le nombre de réponses.
- Une enquête ne peut pas montrer pourquoi une chose s'est produite. Elle peut montrer que les clients qui ont utilisé le chat en direct sont plus satisfaits, mais les clients satisfaits sont peut-être simplement ceux qui prennent la peine d'utiliser le chat. Pour tester une cause, changez une seule chose pour une moitié tirée au hasard et comparez, comme dans un test A/B.
- Elle ne peut pas corriger l'effet de ceux qui n'ont pas répondu. Toutes les formules de cette page supposent un échantillon aléatoire. Si 12 % des clients ont répondu et qu'il s'agit des plus engagés, le biais peut dépasser la marge d'erreur, et aucun test ne le détecte. Comparez les répondants à la liste complète sur les champs dont vous disposez déjà (offre, région, ancienneté), et nettoyez les données avant de tester quoi que ce soit.
- Elle n'a rien à tester quand tout le monde a répondu. Si les 85 personnes d'une équipe ont répondu, il n'y a pas d'erreur d'échantillonnage : l'écart entre deux groupes est ce qu'il est. Reste à savoir s'il est assez grand pour agir et s'il dure.
- Elle ne peut pas distinguer un vrai changement d'un changement de méthode. Si la formulation, le canal ou le public ont changé entre deux vagues, l'écart mélange les deux.
- Elle mesure mal les événements rares. Un phénomène qui touche 1 % des personnes apparaît dans environ 3 réponses sur 300. Utilisez plutôt des données opérationnelles.
- Elle ne garantit pas les comportements. L'intention déclarée d'acheter, de renouveler ou de partir prédit mal ce que les gens font : comparez-la à ce qu'ils ont fait ensuite.
Erreurs fréquentes
- Annoncer une « hausse » ou une « baisse » sans test. Faites le test z ou montrez l'intervalle de l'écart.
- Juger un écart selon que deux marges se chevauchent ou non. Testez l'écart directement.
- Publier des pourcentages pour des segments d'une douzaine de personnes. Affichez le n, fixez un seuil et regroupez les petits groupes.
- Tester chaque cellule d'un tableau croisé et ne publier que celles qui sont sorties significatives. Planifiez les comparaisons ou corrigez pour les tests multiples.
- Considérer p < 0,05 comme « important ». Indiquez l'ampleur de l'écart et s'il franchit votre seuil d'action.
- Prendre le nombre d'invités comme n. Prenez le nombre de personnes qui ont répondu à la question.
- Traiter un sondage ouvert à participation volontaire comme un échantillon aléatoire. Dites de quel échantillon il s'agit et ce qu'il ne peut pas représenter.
Le faire dans Claform
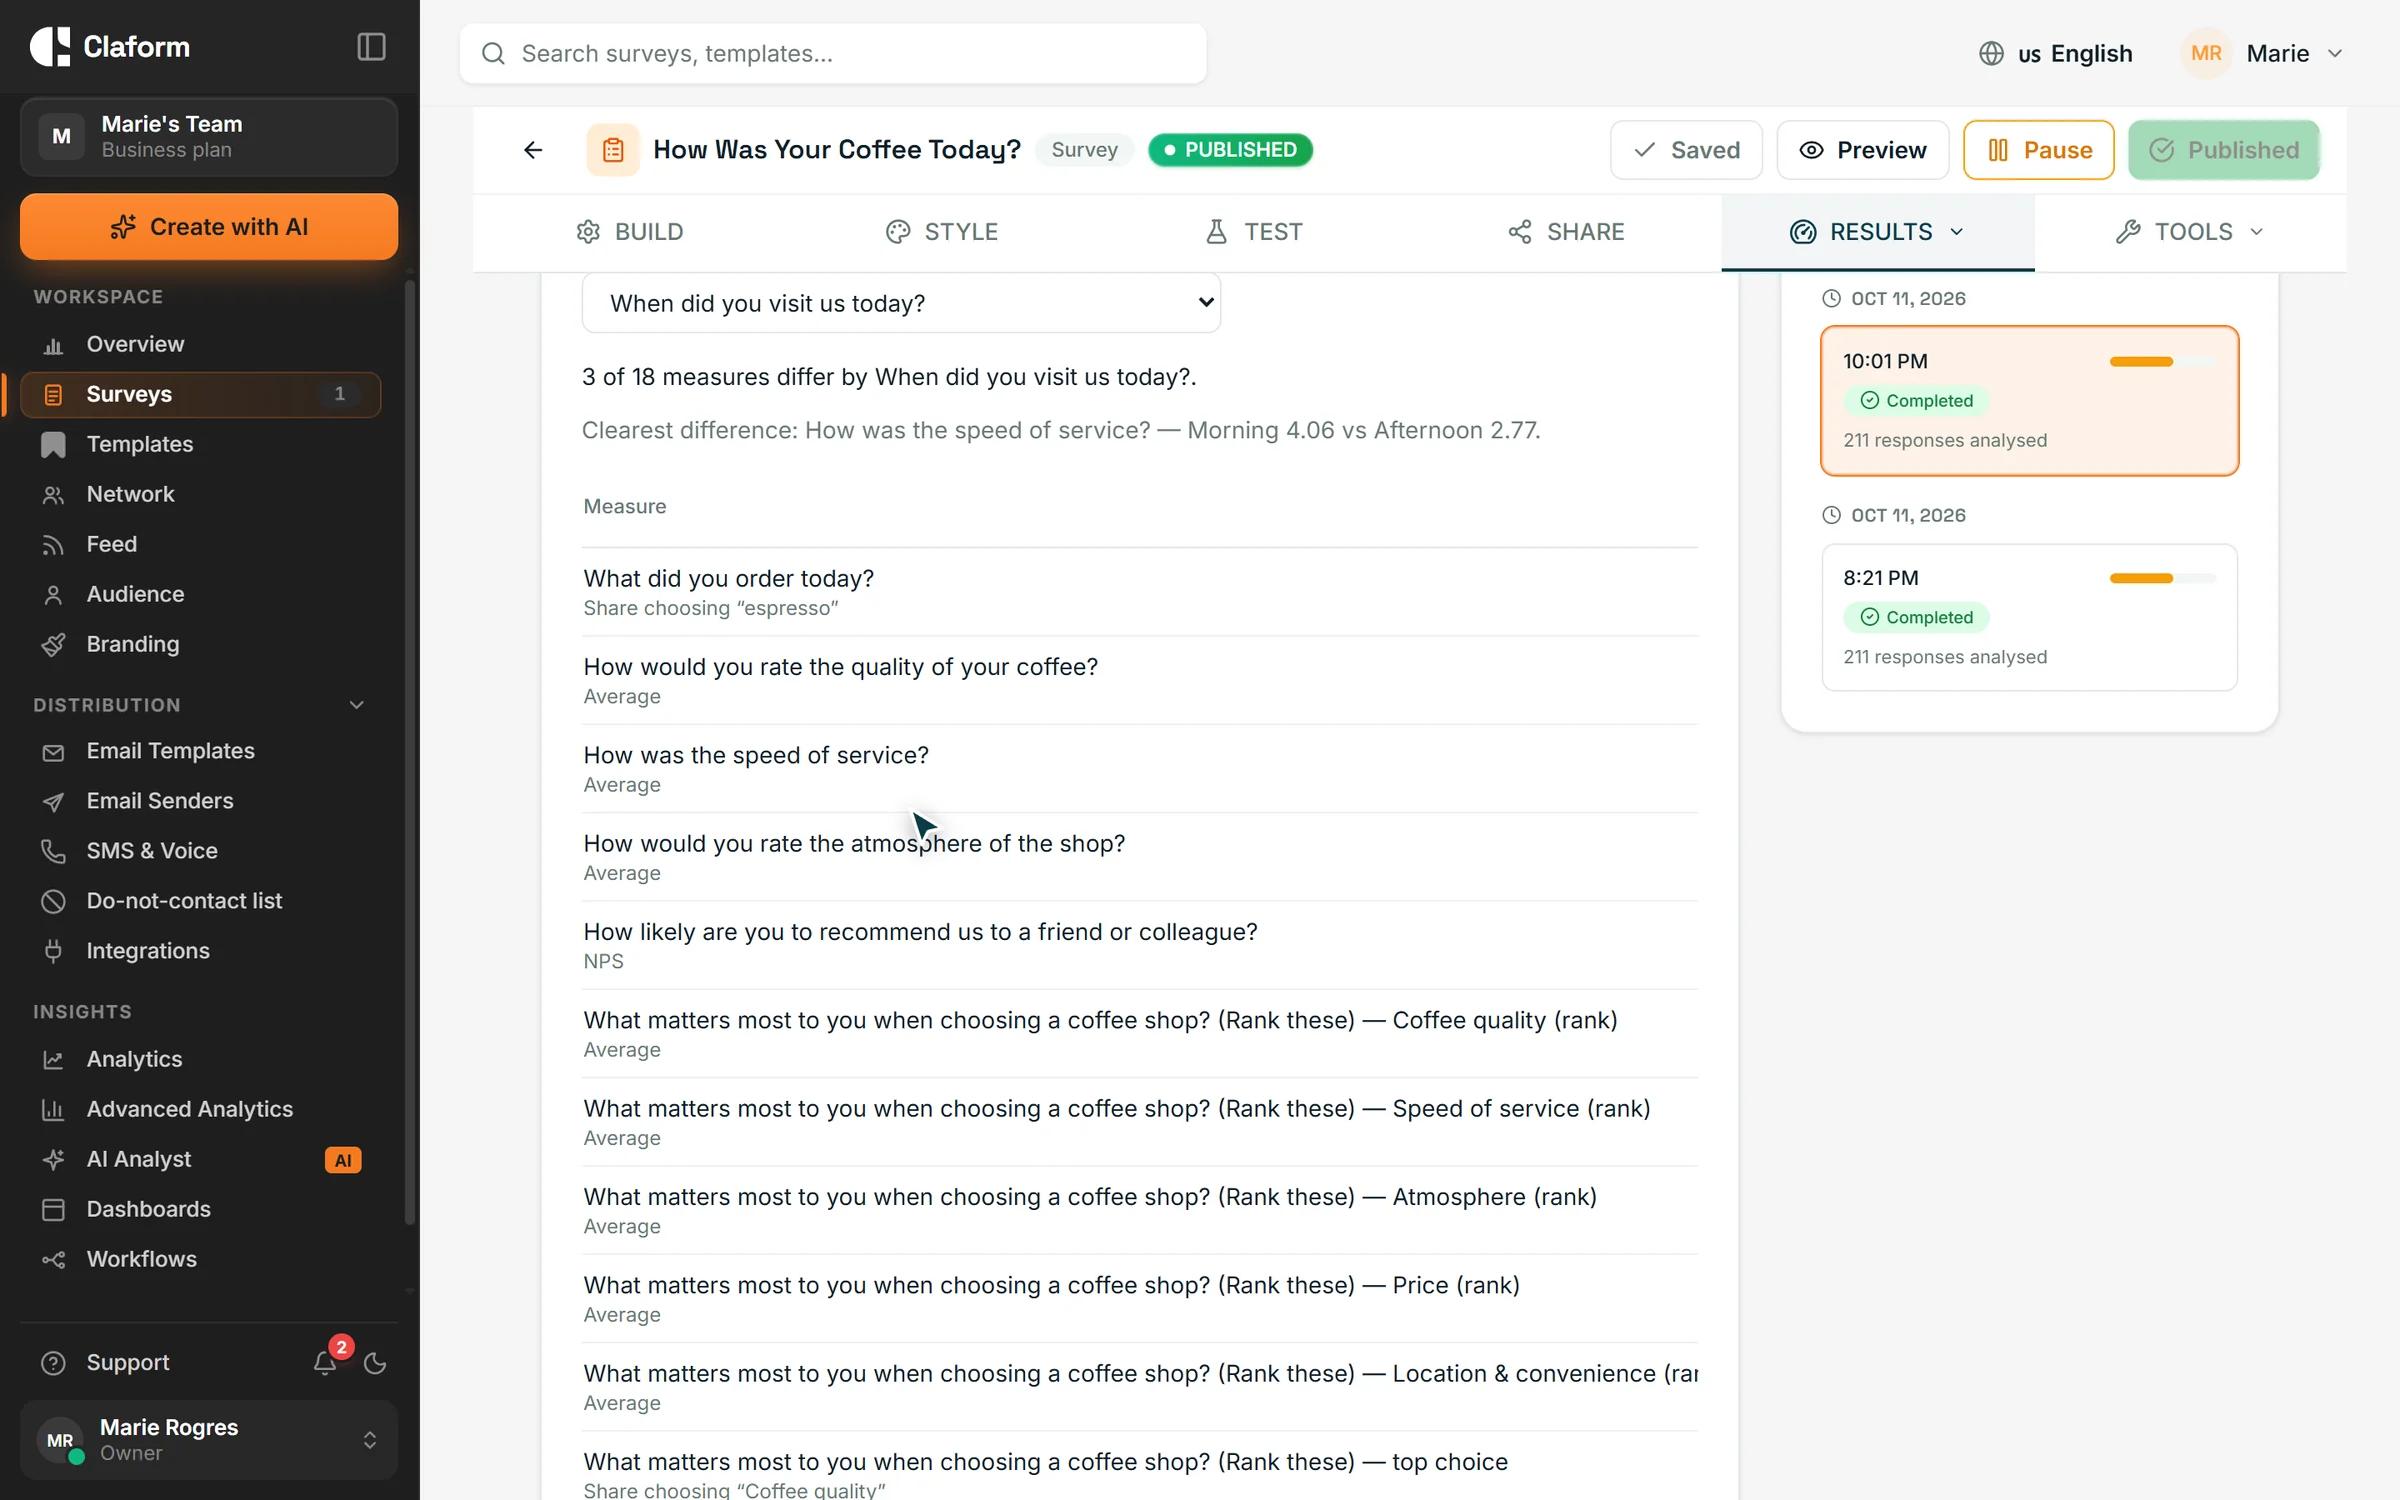
Le calculateur de marge d'erreur et le calculateur de taille d'échantillon appliquent les formules de cette page, y compris la correction pour population finie lorsque la population est petite. Dans l'AI Analyst, disponible avec l'offre Professional et les offres supérieures, la comparaison par question ventile chaque mesure selon une question, comme le lieu ou l'offre, signale les petits groupes et n'affiche pas les groupes de moins de dix réponses. Une analyse approfondie calcule des tests du khi-deux, des tests t, des ANOVA et des corrélations corrigés pour les tests multiples, présente les tailles d'effet avec des intervalles à 95 % et signale les petits échantillons avant de rédiger ses recommandations, chacune renvoyant à la statistique sur laquelle elle s'appuie.
Questions fréquentes
Quelle valeur p est considérée comme significative dans une enquête ?
Par convention, p < 0,05, ce qui correspond à un niveau de confiance de 95 %. C'est une convention, pas une loi. Utilisez 0,01 lorsqu'une fausse alerte coûterait cher ou que vous réalisez de nombreux tests, et considérez les résultats entre 0,05 et 0,10 comme des signaux à surveiller plutôt que comme des résultats. Indiquez toujours l'ampleur de l'écart à côté de la valeur p.
Combien de réponses faut-il pour détecter un écart entre deux groupes ?
Plus que pour une estimation unique. Pour détecter un passage de 58 à 64 % avec un niveau de confiance de 95 % et une puissance de 80 %, c'est-à-dire 80 % de chances de repérer un écart réel de cette taille, il faut environ 1 034 réponses par groupe. Diviser par deux l'écart à détecter multiplie l'échantillon par quatre environ.
Peut-on utiliser un test t sur les moyennes d'une échelle de notation ?
Oui. Pour comparer des notes moyennes entre deux groupes, le test t de Welch est le choix habituel, et avec quelques dizaines de réponses par groupe il se comporte bien sur des échelles en cinq points. Présentez aussi la distribution ou la part top-two-box, car des moyennes égales peuvent masquer des répartitions très différentes. Pour trois groupes ou plus, utilisez l'ANOVA.
Une variation de 5 points du NPS est-elle significative ?
Généralement non, sauf si les deux échantillons sont grands. Le NPS soustrait une proportion d'une autre, si bien que sa marge d'erreur est plus large que celle d'un simple pourcentage : environ ±9 points avec 300 réponses et un NPS de 25. Utilisez la formule de l'erreur type du NPS donnée sur cette page, ou testez séparément les parts de promoteurs et de détracteurs.
Quelle est la différence entre marge d'erreur et significativité statistique ?
La marge d'erreur décrit l'incertitude autour d'un résultat. Un test de significativité se demande si l'écart entre deux résultats dépasse leur incertitude combinée. L'écart a sa propre marge, plus large : comparez donc deux résultats avec un test plutôt qu'en vérifiant si leurs marges individuelles se chevauchent.